giovedì 10 novembre 2011

METODO DI GAUSS-JORDAN E SUE ORIGINI ANTICHE

La geometria è sempre stata e rimane una delle discipline più importanti all'interno della Matematica.
La geometria che si studia a scuola è basata sul sistema assiomatico di Euclide, nella conformazione moderna fornitagli, al termine del XIX secolo, nell'opera Fondamenti della Geometria, da David Hilbert, il quale, per chi non lo sapesse, è colui che nel 1900, ad una conferenza tenutasi a Parigi, stabilì una lista di 23 importantissimi problemi matematici da risolvere (alcuni dei quali effettivamenti dipanati).
La geometria, come sappiamo, prende come riferimento alcuni enti primitivi (punto, retta, piano) e alcuni assiomi fondamentali su cui basare tutti i teoremi e le nozioni geometriche che conosciamo.
Bisogna riconoscere ad Euclide il merito di aver introdotto (in geometria) un sistema deduttivo e rigoroso, il quale consente a un teorema (matematico appartenente a qualsiasi branca) di essere valido per sempre, a condizione che venga dimostrato.
Questa è la base dello sviluppo matematico: considerare un certo enunciato (ipotesi, congettura, ecc.) e fornirne una dimostrazione che non lasci spazio a discussioni!
Tale procedimento è valido dalle questioni più "stupide", come accertarsi che 1 è maggiore di 0, fino alle questioni più complesse, spinose e importanti dell'intero universo matematico, come, ad esempio, la dimostrazione dell'ipotesi di Riemann concernente i numeri primi.
Risulta pertanto necessario affermare che la geometria euclidea, seppur antica di millenni, rimane sempre valida e riesce a spiegare in maniera molto accurata la realtà quotidiana che ci circonda.
Nella descrizione delle strutture del nostro Universo servono invece le cosiddette geometrie non euclidee, per la cui trattazione vi rimando all'articolo "Geometria euclidea: no, geometrie non euclidee!" .
Ora però spalanchiamo le porte ad un mondo più astratto, quello dell'algebra lineare, che sta alla base della moderna geometria analitica, sviluppatasi alla fine del XIX secolo.
La suddetta geometria si fonda sul concetto di vettore.
Il vettore, nel modo più semplice possibile, si può definire un segmento orientato avente 3 caratteristiche fondamentali:

1) modulo o intensità: equivale alla lunghezza del segmento, cioè al valore numerico che esprime;
2) direzione;
3) verso.


Se 2 vettori possiedono la stessa direzione, lunghezza e verso, si dicono equipollenti.
Se vogliamo essere più pignoli, "equipollenti" significa che tali segmenti orientati giacciono su rette parallele (eventualmente coincidenti) e si possono sovrapporre in modo che i loro punti iniziali e finali coincidano perfettamente.


Una delle motivazioni principali della scelta dei vettori come base su cui fondare la geometria risiedeva nella necessità di esprimere le leggi dell'elettromagnetismo in modo indipendente dalle coordinate.
Non a caso, fra i creatori della teoria c'è persino Maxwell, il padre dell'elettromagnetismo, assieme al fisico matematico Josiah Willard Gibbs e al fisico e ingegnere Oliver Heaviside, noto soprattutto per la funzione a gradino che prende il suo nome:


A detta dello storico della matematica Morris Kline, Heaviside riteneva l'analisi vettoriale "una forma abbreviata dell'ordinaria geometria analitica cartesiana".
Precisiamo che la scuola di pensiero fondata negli anni '40 dell'Ottocento da Gibbs e Heaviside, a differenza di quella sviluppata da William Hamilton (per maggiori informazioni vi rimando all'articolo "2 termini celebri in matematica: indeterminato e impossibile"), separava le componenti scalare (lo scalare è un numero puro) e vettoriale del quaternione (a + bi + cj + dk) e le considerava entità indipendenti fra loro.
Gibbs e Heaviside aprirono la strada alla moderna analisi vettoriale non per ragioni di pura matematica, bensì per ragioni relative alla fisica: cercavano infatti un'algebra che facesse al caso loro, e se questo voleva dire fare a pezzi i quaternioni di Hamilton, non si ponevano nessuno scrupolo.
Adesso, per proseguire nella trattazione, dobbiamo introdurre un concetto molto importante in geometria, ovvero quello di campo.
Un campo è una terna (K, +, ∙) formata da:
  • un insieme non vuoto K;
  • 2 operazioni binarie su K, ossia 2 applicazioni:
1) +:K×K→K                       (dove ":" significa "tale che")
2) ∙:K×K→K

denominate rispettivamente "somma" e "prodotto", che associano ad ogni coppia di elementi (a,b) appartenenti (∈) a K×K rispettivamente un elemento:

- a + b ∈ K ("somma di a più b");
- ab ("prodotto di a per b"),

in modo tale che risultino soddisfatti i seguenti assiomi:

K1) Commutatività della somma: a + b = b + a         per ogni (∀) a,b ∈ K;
K2) Associatività della somma: a + (b + c) = (a + b) + c         ∀a,b,c ∈ K;
K3) Esistenza dello zero: esiste (∃) un elemento 0∈K tale che (⎮) a + 0 = 0 + a = a        ∀a ∈ K;
K4) Esistenza dell'opposto: ∀a ∈ K   ∃a' ∈ K ⎮a + a' = 0;
K5) Commutatività del prodotto: ab = ba            ∀a,b ∈ K;
K6) Associatività del prodotto: a(bc) = (ab)c          ∀a,b,c ∈ K;
K7) Esistenza dell'unità: ∃1∈K ⎮a1 = 1a = a          ∀a ∈ K;
K8) Esistenza dell'inverso: ∀a ∈ K, a ≠ 0, ∃a∗ ∈ K ⎮aa∗ = 1;
K9) Distributività della somma rispetto al prodotto: a(b + c) = ab + ac            ∀a,b,c ∈ K;
K10) Non-esistenza di divisori dello zero: se ab = 0 e b ≠ 0, allora a = 0.

Se la terna (K, +, ∙) soddisfa gli assiomi K1,...,K7,K9,K10, ma non necessariamente K8, essa è detta: dominio (o dominio d'integrità).
Con le tradizionali operazioni l'insieme Z dei numeri interi relativi è un dominio.
Invece, gli insiemi Q (numeri razionali), R (numeri reali), C (numeri complessi), assieme alle loro operazioni sono campi.
Una piccola divagazione a proposito degli insiemi numerici fondamentali: alcuni matematici hanno ideato un modo simpatico e bizzarro per farli ricordare: basta tenere a mente la frase senza senso "Nine Zulu Queens Ruled China" (Nove regine zulù governavano la Cina) ed il gioco è fatto!
Infatti, ciascuna iniziale delle parole contenute nella frase sopracitata rappresenta un insieme numerico fondamentale: N,Z,Q,R,C!
Ora, ritornando seri, andiamo a vedere cos'è una matrice.
Una matrice A di tipo (m,n) (possiamo anche chiamarla matrice m × n) con m,n interi positivi, a elementi in un campo K è una tabella rettangolare di numeri


disposti in m righe e n colonne.
aij è il numero che si trova sulla i-esima riga e sulla j-esima colonna di A.
In termini più rigorosi si dice che aij è l'elemento di posto (i, j) della matrice A.
Di seguito alcuni semplici esempi di matrici:


In particolare, nel secondo caso abbiamo di fronte una matrice quadrata (presenta lo stesso numero di righe e colonne), nel terzo caso abbiamo una matrice unità (o matrice identità o matrice identica) e nel quarto caso una matrice nulla (o matrice zero).
Consideriamo ulteriori 2 esempi:


La prima matrice, costituita da 3 righe e da una sola colonna, è un esempio di vettore colonna, mentre la seconda matrice, formata da 3 colonne e una riga, rappresenta un caso di vettore riga.
Detto ciò, sorge una domanda, che cos'è il metodo di Gauss-Jordan a cui allude il titolo dell'articolo e cosa ha a che spartire con tutto ciò descritto in precedenza?
Il metodo (di eliminazione) di Gauss-Jordan non è altro che un importante metodo (dell'algebra lineare) di risoluzione dei sistemi di equazioni, il quale sfrutta pure le sopracitate matrici!
Consideriamo quindi un generico sistema di equazioni lineari:


Esso è un sistema di m equazioni lineari nelle n incognite X1,...,Xn.
Il sistema viene definito omogeneo se b1 = b2 = ... = bm = 0.
In caso contrario, il sistema è ovviamente detto non omogeneo.
Dal sistema possiamo ricavare una particolare matrice, denominata matrice dei coefficienti A:


Adesso raggruppiamo le incognite per formare il vettore x delle incognite:


e pure i termini noti per costituire il vettore b dei termini noti:


Si può inoltre definire la matrice completa (o orlata), ottenuta aggiungendo ad A il vettore colonna b:
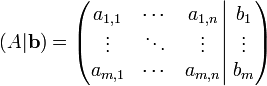


Per indicare in maniera semplice il sistema possiamo pertanto utilizzare l'espressione Ax = b.
Ad esempio, prendendo il sistema:


Otteniamo la matrice completa:


Abbiamo dunque visto che qualunque sistema di equazioni lineari può essere trascritto in una matrice orlata (e viceversa).
Ma come si risolve un sistema?
Un procedimento di risoluzione è appunto l'algoritmo di Gauss-Jordan.
Il suddetto metodo consente infatti di stabilire se il sistema risulta compatibile (ovvero se ammette soluzioni) oppure no, e nel caso sussistano soluzioni, permette di trovarle tutte.
Il procedimento consiste nel sostituire il sistema dato con un sistema "triangolare" ad esso equivalente, ottenuto tramite una serie di passaggi chiamati "operazioni elementari sulle equazioni del sistema".
Tali operazioni corrispondono ad altrettante operazioni sulle righe della matrice completa.
Ergo, osserviamo quali sono le operazioni elementari che si possono attuare sulle equazioni di un sistema:

1) scambiare fra loro 2 equazioni del sistema;
2) moltiplicare (primo e secondo membro) di un'equazione per uno stesso scalare non nullo;
3) sostituire un'equazione con quella ottenuta sommando ad essa un multiplo di un'altra equazione.

Queste operazioni si possono tradurre, nell'ambito delle matrici, come operazioni sulle righe di una matrice:

1) scambiare tra loro 2 righe della matrice;
2) moltiplicare una riga della matrice per uno scalare non nullo;
3) sostituire una riga della matrice con quella ottenuta sommando ad essa un multiplo di un'altra riga.

Pertanto, trattasi di operazioni veramente semplici da comprendere e da attuare.
Ora mettiamo in pratica il metodo di Gauss-Jordan: riprendiamo il sistema precedente:


Dobbiamo ottenere, mediante le operazioni elementari elencate sopra, un sistema che permetta una "sostituzione all'indietro", cioè un sistema che nella prima equazione presenti tutte e 3 le incognite (x,y,z), nella seconda equazione 2 incognite (y,z) e nella terza un'incognita (z).
È sicuramente più facile capire il concetto risolvendo esplicitamente il sistema: procediamo!
Abbiamo il sistema; il nostro primo obiettivo è quello di eliminare x dalla seconda e terza equazione.
Come facciamo?
Semplice: utilizziamo le operazioni elementari.
Dunque, sottraiamo 2 volte la prima equazione dalla seconda e sottraiamo -1 volte la prima equazione dalla terza.
Otteniamo così il sistema equivalente:


Il coefficiente 2 della prima equazione si dice primo pivot.
Abbiamo eliminato la x dalla seconda e terza equazione: adesso dobbiamo eliminare la y dalla terza equazione.
A tal scopo sottraiamo -1 volte la seconda equazione dalla terza:


Il coefficiente -8 della seconda equazione è chiamato secondo pivot, mentre il coefficiente 1 della terza equazione è detto terzo pivot.
Finalmente siamo giunti ad un sistema equivalente (in una forma "triangolare) che ci permette di trovare le soluzioni sostituendo all'indietro.
Alla fine le soluzioni sono: z = 2, y = 1, x = 1.
Lo stesso però si può fare in maniera molto più rapida sfruttando le matrici.
Riprendiamo la matrice completa associata al sistema di partenza:


Il nostro obiettivo sarà rendere 0 il primo valore della seconda riga, e rendere 0 i primi 2 valori della terza riga, ovviamente attraverso le operazioni elementari sulle righe.


Non abbiamo fatto altro che lo stesso procedimento di prima, questa volta, tuttavia, con le matrici, ottenendo una matrice a gradini (o a scala).
Se volete la conferma che il risultato è lo stesso, riscrivete l'ultima matrice sotto forma di sistema e vedrete che è esattamente uguale a quello da cui abbiamo ricavato le soluzioni (z = 2, y = 1, x = 1) in precedenza.
Facciamo un ulteriore esempio, questa volta con un sistema avente 4 equazioni e 4 incognite:


Procediamo direttamente con il metodo di Gauss-Jordan per le matrici; ergo, scriviamo la matrice completa:


La prima cosa da fare è far diventare 0 il primo termine della seconda riga: addizioniamo la seconda riga con la prima riga moltiplicata per -1:


Ora, cerchiamo di far diventare 0 il primo elemento della terza riga, sommando -1 volte la prima riga alla terza riga:


Adesso possiamo fare una bella e assai conveniente cosa: scambiamo fra loro la seconda e la terza riga:


Ora dobbiamo solamente sistemare l'ultima riga: innanzitutto sommiamo -2 volte la prima riga alla quarta riga:


Dopodiché, sommiamo -1 volte la seconda riga alla quarta:


Infine, sommiamo 4 volte la terza riga alla quarta riga:


Finalmente abbiamo una matrice a gradini!
Scrivendo il sistema associato e risolvendo con sostituzione all'indietro otteniamo i risultati:
  • w = 3;
  • z = -1;
  • y = 2;
  • x = 1
Riassumendo, come abbiamo potuto constatare, il metodo di Gauss-Jordan è sicuramente molto utile nella risoluzione di sistemi di equazioni, anche se, come tutti i metodi, ha i suoi pro e contra!
A proposito di tale metodo, Gauss scrisse che “grandemente riduce il tedio dei calcoli meccanici, successo avrà chi lo utilizza”.
Ma qual è esattamente la storia del metodo di Gauss-Jordan? 
Forse non ci crederete, ma per risalire alle origini del suddetto metodo dobbiamo fare un pazzesco salto temporale all'indietro, verso l'antica Cina. 
Gli antichi cinesi furono i primi ad utilizzare un sistema di numerazione posizionale, un migliaio di anni prima degli occidentali, per fare i calcoli con delle bacchette di legno.
Per i cinesi i numeri assunsero da sempre un ruolo di primo piano nella loro vita: si narra addirittura che fu l'Imperatore Giallo (Huang Di), intorno al 2400 a.C. circa, a chiedere alle divinità di creare la Matematica.
La Matematica era di importanza vitale per il buon funzionamento del regno, un regno gigantesco e in continua espansione.
L'Impero necessitava di abili amministratori, competenti appunto in Matematica.
Per istruire i funzionari veniva quindi utilizzato un manuale denominato "Nove capitoli sulle arti matematiche" (Jiuzhang Suanshu).
Da prove interne all'opera e da alcuni commenti apportati dai curatori delle ultime versioni, possiamo datare il libro originale dei Nove capitoli al tempo della dinastia degli Han "anteriori", la quale regnò dal 202 a.C. al 9 d.C.
Questo fu uno dei periodi di massimo splendore nella storia cinese, il primo nel quale l'Impero raggiunse un'estensione paragonabile alla Cina moderna.
Il testo, rappresentante il più autorevole trattato matematico antico cinese, è una raccolta di 246 problemi, inerenti questioni relative al commercio e al pagamento delle tasse.
Nel 263 d.C., il matematico Liu Hui scrisse e pubblicò un libro con le soluzioni ai problemi presenti nei Nove capitoli.
Si ritiene che proprio Lui Hui sia colui che ha ideato un metodo precursore del moderno algoritmo di Gauss-Jordan.
Infatti, nell'ottavo capitolo del noto testo antico cinese, è presente un problema sulla misura del grano.
L'enunciato del problema è questo:

"Ci sono 3 tipi di grano. 3 cesti del primo tipo, 2 del secondo e uno del terzo pesano complessivamente 39 misure. 2 cesti del primo, 3 del secondo e uno del terzo pesano 34 misure. E un cesto del primo, 2 del secondo e 3 del terzo pesano 26 misure. Quante misure di grano sono contenute in un cesto di ogni tipo?"

Possiamo riscrivere il problema in forma moderna, mediante un sistema di equazioni lineari:


Ovviamente, per quanto ci riguarda, la risoluzione del sistema non crea particolari difficoltà, ma come lo ha risolto Liu Hui?
Innanzitutto, moltiplica la seconda equazione per 3 (ottenendo così 6x + 9y + 3z = 102); poi sottrae la prima equazione da questa 2 volte.
In maniera analoga, moltiplica la terza equazione per 3 (ottenendo 3x + 6y + 3z = 78) e sottrae la prima equazione da questa una sola volta.
In tal modo, ottiene il sistema:


Egli moltiplica a questo punto la terza equazione per 5 (ottenendo 20y + 40z = 195) e sottrae dal risultato la seconda equazione 4 volte.
La terza equazione diviene allora: 36z = 99, ossia z = 11/4.
Sostituendo questo valore nella seconda equazione si ricava y = 17/4 e poi x = 37/4.
MA QUESTO NON È APPUNTO IL METODO DI GAUSS-JORDAN?
Esattamente: poniamo di nuovo in rilievo che un metodo di risoluzione di sistemi dell'algebra lineare, sviluppato nel XIX secolo, in realtà risale a quasi 2000 anni prima!
Una sola parola: INCREDIBILE!
Dopo tali informazioni sbalorditive, ci proponiamo di far luce su altri 2 interrogativi finali:

1) in che occasione il celebre "princeps mathematicorum" Carl Friedrich Gauss introdusse il metodo?
2) chi è Jordan?

Gauss, fra il 1803 e il 1809, compì alcune osservazioni sull'asteroide Pallade e ne calcolò l'orbita.
Per riuscire nell'impresa, era necessario risolvere un sistema di 6 equazioni lineari in 6 incognite.
Mise dunque a punto il metodo di cui abbiamo parlato fino ad adesso.
E Jordan?
Wilhelm Jordan (1842-1899), nacque a Ellwangen, una piccola città nel sud della Germania.
Egli studiò all'instituto politecnico di Stoccarda.
Successivamente al lavoro, della durata di 2 anni, in veste di assistente ingegnere alle fasi preliminari della costruzione delle ferrovie, ritornò nel 1865 a Stoccarda come assistente in geodesia.
Dal 1881 fino alla sua morte fu professore di geodesia e geometria pratica all'università di Hannover.
Scrisse un manuale di geodesia (Handbuch der Vermessungskunde), rappresentante la sua opera più famosa.
L'algoritmo di Gauss-Jordan apparve nel 1888 nella terza edizione del suo manuale di geodesia.
Qual è il miglioramento apportato da Jordan al metodo tradizionale di Gauss?
Ebbene, Jordan ha fatto sì che il procedimento consenta di calcolare anche l'inversa di una matrice.
Aggiungo solo che una matrice quadrata A si dice invertibile se esiste una matrice M tale che AM = MA = I, dove I è la matrice identità.
Se esiste, M è unica ed è chiamata inversa di A, denotandola con la notazione A − 1.
Vorrei concludere con alcune considerazioni: siamo entrati nel mondo della geometria e abbiamo scoperto alcuni strumenti dell'algebra lineare.
Poi ci siamo soffermati sulle matrici e sul metodo di Gauss-Jordan.
La cosa che mi preme sottolineare nuovamente e maggiormente è però che tale procedimento, studiato oggi al liceo scientifico (forse) e in corsi universitari scientifici, risale a oltre 2000 anni fa.
Ciò è un piccolo ma significativo esempio del fatto che le civiltà antiche, a differenza di come comunemente ritenuto, erano veramente avanti in campo matematico e scientifico; dobbiamo a loro le fondamenta, le radici della nostra moderna cultura scientifica.

giovedì 27 ottobre 2011

6 FAMOSI ESPERIMENTI DELLA STORIA DELLA FISICA

La vera Fisica, fin dalle sue origini con i contributi di Galileo Galileo, si basa, oltre che sulle idee di menti geniali come quelle di Einstein, Newton, Maxwell, Feynman, ecc. e sulla Matematica, anche sugli esperimenti.
Infatti, proprio Galileo aveva introdotto il metodo scientifico, una serie di passi fondamentali che lo scienziato deve compiere affinché voglia realmente dimostrare che la sua ipotesi concorda con la realtà.
L'ultimo passo risiede proprio nell'esperimento.
Esso può riguardare qualunque branca della fisica, dalla meccanica alla termodinamica, dall'elettromagnetismo alla relatività e così via.
I più importanti esperimenti oggi condotti sono quelli fatti per mezzo degli acceleratori di particelle, al fine indagare al meglio il mondo microscopico e cercare di svelare gli arcani misteri che lo contraddistinguono.
Basti pensare all'esperimento OPERA sui neutrini, che avrebbe (uso il condizionale perchè la situazione è ancora da verificare e chiarire) mostrato tali particelle superare la fantomatica velocità della luce!
Per quanto concerne l'esperimento sui neutrini vi rimando all'articolo "Neutrini: più veloci della luce?"
In questo contesto andremo quindi ad analizzare alcuni famosi esperimenti che sono occorsi nella storia della Fisica.
Nello specifico, parleremo di 6 esperimenti.
Perché ho scelto di trattarne esattamente 6?
Perchè 6 è il vero "numero perfetto"!
La gente che ignora la Matematica generalmente attribuisce al 3 il ruolo di "numero perfetto" e portandoci indietro nel passato, i Pitagorici ritenevano che fosse invece il 10 il "numero perfetto", in quanto asserivano che esso incarnasse tutti i presupposti della perfezione.
Infatti, tra 1 e 10 erano compresi tanti numeri primi (2,3,5,7) quanti non primi (4,6,8,9) e il 10 era il numero più piccolo a possedere tale singolare proprietà.
Euclide fu il primo a considerare la definizione adottata ancora oggi di "numero perfetto": un numero che è pari alla somma di tutti i suoi divisori.
Facciamo qualche prova: consideriamo il 3, quello che comunemente viene designato come "perfetto"; il suo unico divisore è l'1: non è un numero perfetto.
Prendiamo il 4; i suoi divisori sono 1,2, ma 1 + 2 = 3: non è "perfetto".
Prendiamo il 5: il suo unico divisore è l'1 (alla stregua del 3 è un numero primo): non "perfetto".
Arriviamo finalmente al 6: i suoi divisori sono 1,2,3; 1 +2 + 3 = 6: ecco finalmente il primo "numero perfetto": il 6!
Volete sapere quale numero assume il ruolo di secondo "numero perfetto": il 28.
Infatti, i suoi divisori sono 1,2,4,7,14; 1 + 2 + 4 + 7 + 14 = 28.
Ora, dopo questa breve divagazione matematica, passiamo al nocciolo della questione: i 6 esperimenti a cui ho accennato sopra.
Visto che ho parlato di velocità della luce in precedenza, colgo l'occasione per iniziare la trattazione dall'Esperimento di Michelson-Morley.

1) ESPERIMENTO DI MICHELSON-MORLEY

Le prime proposte per determinare la velocità della luce risalgono al 1629, dovute all'olandese Isaac Beeckman.
Poi, nel 1676, Ole Rømer compì la prima determinazione quantitativa, per mezzo di osservazioni astronomiche.
Spostandoci avanti di circa 2 secoli, arriviamo negli anni '50 del XIX secolo, in cui 2 fisici francesi, Fizeau (prima) e Foucault (dopo), realizzarono i primi esperimenti a terra.
Ci troviamo quindi in un arco temporale precedente alla rivoluzione stabilita dalla Relatività Speciale introdotta da Einstein a partire dal 1905.
Pervenendo al nocciolo della questione, nel 1887 Albert Abraham Michelson e Edward Morley eseguirono uno degli esperimenti più noti e importanti della fisica di tutti i tempi.
Ricordiamo che Maxwell aveva scritto 4 equazioni sintetizzanti l'intero elettromagnetismo e in accordo con tali leggi, il campo elettromagnetico è descritto da un'equazione in cui appare una costante universale stabilente la velocità di propagazione di ogni onda elettromagnetica (e quindi anche della luce) nel vuoto.
La cosa singolare è però che tale velocità (indicata comunemente con c) è una velocità "assoluta", cioè non dipende dal sistema fisico che prendiamo come riferimento: rimane sempre la stessa: 299.792.458 m/s.
Generalmente, quando stiamo in moto e lanciamo ad esempio una pallina, la velocità di quest'ultima, in accordo con le leggi della Meccanica Classica, sarà pari alla somma tra la nostra velocità e quella del lancio.
Ma la tendenza generale nel mondo scientifico (prima di Einstein) era quello di rinunciare al principio di relatività (introdotto da Galileo per le leggi meccaniche) supponendo l'esistenza di un mezzo impalpabile, detto etere, che riempiva uniformemente lo spazio vuoto, e individuava tra i sistemi di riferimento inerziali uno che fosse privilegiato, non altri che quello in quiete rispetto all'etere stesso.
Dopo queste brevi precisazioni, ci poniamo una domanda: cosa ci ha fatto scoprire l'esperimento di Michelson-Morley?
Esso ha portato alla conclusione che l'ipotesi dell'etere non è realistica, servendo così (18 anni dopo) "su un piatto d'argento" la strada ad Einstein per implementare la sua Relatività.
In cosa consiste però il suddetto esperimento?
Vi riporto la descrizione che fornisce Richard Feynman nelle sue famosissime "Lectures on Physics":


"L'esperimento di Michelson fu eseguito con un dispositivo [detto interferometro che] consiste essenzialmente di una sorgente di luce A, una lastra di vetro parzialmente argentato B, e 2 specchi C ed E, il tutto montato su una base rigida. Gli specchi sono posti a uguali distanze l da B. La lastra B divide un fascio di luce che arriva, e i 2 fasci risultanti proseguono in direzioni fra loro perpendicolari, fino agli specchi, dove sono riflessi indietro verso B. Ritornando a B, i 2 fasci sono ricomposti come 2 fasci sovrapposti D e F. Se il tempo impiegato dalla luce per andare da B a E e ritorno è lo stesso del tempo impiegato per andare da B a C e ritorno, i fasci emergenti D e F saranno in fase e si rinforzeranno l'un l'altro, ma se i 2 tempi sono lievemente diversi, i fasci saranno lievemente sfasati e si avrà l'interferenza. Se il dispositivo è "immobile" nell'etere, i tempi dovrebbero essere esattamente uguali, ma se esso è in movimento verso destra con velocità v, dovrebbe esserci una differenza nei tempi. Vediamo perché. Prima di tutto, calcoliamo il tempo necessario alla luce per andare da B a E e ritorno. Diciamo che il tempo perché la luce vada dalla lamina B allo specchio E è t1 e il tempo per il ritorno è t2. Ora, mentre la luce viaggia da B allo specchio, il dispositivo si muove di un tratto vt1, così la luce deve percorrere una distanza l + vt1 alla velocità c. Possiamo anche esprimere questa distanza come ct1, così abbiamo:

ct1 = l + vt1,          o        t1 = l/(c-v)

In un modo simile può essere calcolato il tempo t2. Durante questo tempo la lamina B avanza di un tratto vt2, così il tratto di ritorno della luce è l - vt2. Così abbiamo:   

ct2 = l - vt2,          o        t2 = l/(c+v)

Quindi il tempo totale è:
t1 + t2 = 2lc/(c² - v²).

Per convenienza in un futuro confronto dei tempi, scriviamo questo come:


Il nostro secondo calcolo sarà per il tempo t3 che la luce impiega ad andare da B allo specchio C. Durante il tempo t3 lo specchio C si sposta a destra di un tratto vt3, nella posizione C'; nello stesso tempo, la luce percorre una distanza ct3 lungo l'ipotenusa di un triangolo che è BC'. Per questo triangolo rettangolo abbiamo:

(ct3)² = l² + (vt3)²

ovvero:


da cui otteniamo:


Per il viaggio di ritorno da C' la distanza è la stessa, come si può vedere dalla simmetria della figura; quindi anche il tempo di ritorno è lo stesso, e il tempo totale è 2t3.
Con una piccola risistemazione della forma possiamo scrivere:


Siamo ora in grado di confrontare i tempi impiegati dai 2 fasci di luce. Nelle espressioni


i numeratori sono identici, e rappresentano il tempo che sarebbe impiegato se il dispositivo fosse immobile. Nei denominatori, il termine v²/c² sarà piccolo, a meno che v non sia di grandezza paragonabile a c. I denominatori rappresentano le modifiche nei tempi causate dal moto del dispositivo. Queste modifiche non sono le stesse - il tempo per andare a C e ritorno è un po' minore del tempo per andare a E e ritorno, anche se gli specchi sono equidistanti da B, e tutto quello che dobbiamo fare è misurare con precisione tale differenza. Supponiamo che le 2 lunghezze l non siano esattamente uguali. In effetti non possiamo di sicuro renderle esattamente uguali. In tal caso ruotiamo semplicemente l'apparecchiatura di 90°, cosicché BC sia lungo la linea del moto e BE perpendicolare al moto. Qualsiasi piccola differenza di lunghezza diviene allora priva di importanza, e ciò che cerchiamo è uno slittamento nella frange di interferenza quando ruotiamo il dispositivo. Nel realizzare l'esperimento, Michelson e Morley orientarono il dispositivo in modo che la linea BE fosse quasi parallela al moto della Terra lungo la sua orbita (in certi momenti del giorno e della notte). Questa velocità orbitale è di circa 18 miglia al secondo, e qualsiasi "velocità dell'etere" dovrebbe essere almeno altrettanto in un qualche momento del giorno o della notte e in un qualche periodo dell'anno. Il dispositivo era ampiamente sensibile per l'osservazione di un tale effetto, ma non fu trovata alcuna differenza di tempo - la velocità della Terra attraverso l'etere non poté essere rilevata. Il risultato dell'esperimento fu NULLO. Il risultato dell'esperimento di Michelson-Morley fu molto imbarazzante e creò estremo turbamento."


Pertanto, riassumendo il tutto in poche e semplici parole, l'esperimento di Michelson-Morley determinò con sicurezza assoluta che la velocità della luce, misurata dalla Terra, era indipendente dalla direzione dei raggi luminosi relativamente al moto di rivoluzione della Terra attorno al Sole.
Tuttavia, è necessario precisare che, sebbene Michelson, a seguito dell'esperimento, fosse balzato alla conclusione più ovvia e logica, ovvero che l'etere non esisteva, in realtà ciò non rappresentava l'unica soluzione possibile.
Quei risultati avrebbero anche potuto significare che, per qualche motivo sconosciuto, l'etere riusciva a influenzare la misurazione della velocità della luce, in un maniera incompresibile per gli scienziati. 
Alla fine, la vicenda, come tutti sappiamo, si è conclusa con la sconfitta della teoria dell'etere luminifero e con la vittoria della Relatività Ristretta di Einstein.

2) ESPERIMENTO DI ØRSTED

Nel 1820 il fisico danese Hans Christian Ørsted scoprì un legame inaspettato fra fenomeni elettrici e fenomeni magnetici, attraverso un semplice esperimento.
Infatti, il fisico dispose un filo elettrico, collegato a una batteria, nella direzione nord-sud, sopra un ago magnetico.
Dopodiché, quando faceva passare la corrente nel filo, l'ago ruotava, tendendo a disporsi perpendicolarmente rispetto al filo stesso.
In poche parole Ørsted aveva dimostrato che un filo percorso da corrente elettrica genera un campo magnetico!
La pubblicazione di tale scoperta fu fatta tramite un opuscolo in latino dal titolo Experimenta circa effectum conflictus electrici in acum magneticum.
Il suddetto saggio era soprattutto qualitativo, ma spianò la strada ai successivi sviluppi dell'elettromagnetismo.
La sua importanza venne subito riconosciuta; infatti il saggio fu tradotto in tedesco, francese e inglese, e fu pubblicato sulle riviste scientifiche più rinomate.

3) ESPERIMENTO DI FARADAY

Nel 1821 il fisico inglese Michael Faraday fece un esperimento simile a quello di Ørsted: pose un filo metallico in un campo magnetico, ortogonalmente alle linee di campo.
Diede corrente al filo e ne scaturì il fatto che esso subì l'effetto di una forza perpendicolare sia al filo stesso che alle linee del campo magnetico.
In parole povere: un filo attraversato da corrente, in un campo magnetico, subisce una forza.

4) ESPERIMENTO DI AMPÈRE

L'esperimento condotto dal francese André-Marie Ampère si ricollega direttamente a quelli di Ørsted e di Faraday, generalizzandoli.
Tra l'altro, l'esperimento fu compiuto dallo scienziato francese soltanto una settimana dopo essere venuto a conoscenza di quello del collega danese.
Egli verificò che 2 fili rettilinei e paralleli si attraggono se sono percorsi da correnti elettriche nello stesso verso e viceversa, i 2 fili si respingono se attraversati da correnti elettriche aventi versi opposti.
Eseguendo l'esperimento con 2 fili di gran lunga più lunghi della distanza che li separa, ottenne la legge che prende il suo nome: Legge di Ampère:

[La forza che agisce su una porzione, lunga l, di uno dei fili è direttamente proporzionale alle 2 correnti circolanti e inversamente proporzioanle alla distanza d tra i 2 fili.]

In simboli:


Se immaginassimo di compiere l'esperimento di Ampère nel vuoto, per il Sistema Internazionale (SI) la costante km si può esprimere come:

km = μ₀/2π

dove μ₀ rappresenta la permeabilità magnetica del vuoto, il cui valore è μ₀ = 4π × 10-⁷ N/A².
Ergo, nel SI è comune scrivere la legge di Ampère come:


Ecco le parole di James Clerk Maxwell sul lavoro di Ampère:

"La ricerca sperimentale con la quale Ampère stabilì le leggi dell'azione meccanica tra correnti elettriche è una delle conquiste più brillanti della scienza. Il tutto, teoria ed esperimento, sembra balzare, adulto e armato, dal cervello del "Newton dell'elettricità". Ha una forma perfetta, di precisione assoluta, ed è compendiato in una formula da cui si possono dedurre tutti i fenomeni, e che rimarrà sempre la formula cardinale dell'elettrodinamica."

5) ESPERIMENTO DI YOUNG

Per quanto concerne l'esperimento della doppia fenditura effettuato da Young, desidero riportare la sublime descrizione che ne fa Silvia Arroyo Camejo nel libro Il bizzarro mondo dei quanti:

"L'esperimento della doppia fenditura, proposto nel 1801 dal versatile talento inglese Thomas Young (1773-1829), sembrò deporre definitivamente a favore della teoria ondulatoria della luce. Secondo un aneddoto divertente, l'idea di occuparsi della capacità di interferenza sarebbe venuta in mente a Young in seguito a ingenue osservazioni naturali. Guardando delle anatre che nuotavano sulla superficie dell'acqua di uno stagno, egli notò come le onde causate dai loro corpi in movimento si sovrapponessero indisturbate le une alle altre. Ispirato da questa scoperta, concepì finalmente il suo esperimento delle 2 fenditure con la luce.....Questo importantissimo esperimento è costruito [così]: una sorgente luminosa emette luce, per quanto possibile monocromatica e coerente, su una lastra non trasparente, sulla quale sono state praticate 2 strette fenditure. Alle spalle della doppia fenditura si colloca uno schermo, sul quale verrà proiettata la parte di luce in grado di attraversare le fessure....Immaginiamoci, per prima cosa, che la sorgente non emetta qualcosa di impalpabile come la luce, ma che emetta invece oggetti concreti e tangibili, a noi più familiari, come per esempio (idealmente) palloni da calcio che un pessimo giocatore, arbitrariamente e senza scopo, tira contro la doppia fenditura, a sua volta pensata come un muro con 2 finestre lunghe e strette....Dietro ogni buco si accumulerà una grande quantità di palloni, indipendentemente dal fatto che ci sia o no anche l'altro buco. Detto in termini formali, nel caso dell'esperimento della doppia fenditura con i palloni, vale allora la seguente relazione: 


cioè la distribuzione di probabilità di arrivo P1+2 in seguito all'apertura di entrambe le fenditure è uguale alla somma delle singole distribuzioni di probabilità P1 e P2, dovute rispettivamente all'apertura della sola fessura 1 o della sola fessura 2....Torniamo adesso al caso della luce e immaginando che questa abbia natura corpuscolare, ci aspettiamo di ottenere sullo schermo di proiezione una distribuzione di probabilità di arrivo dei fotoni simile a quella dei palloni....Se conduciamo l'esperimento aprendo solamente la fenditura 1, teoricamente dovremmo osservare sullo schermo un'unica striscia chiara dietro la fessura, all'incirca della stessa larghezza della fessura stessa. Eseguendo effettivamente questo esperimento, otteniamo sullo schermo esattamente la probabilità di arrivo P1 attesa per i fotoni....Ovviamente, nulla cambia se nell'esperimento apriamo soltanto la fenditura 2....Le nostre riflessioni sull'esperimento della doppia fenditura con palloni da calcio o analoghi oggetti "impacchettabili", ci spingono adesso a supporre che se apriamo contemporaneamente le fessure 1 e 2, la distribuzione di probabilità finale dei fotoni debba eguagliare la somma delle distribuzioni ottenute aprendo solo la fenditura 1 o solo la fenditura 2....Ebbene, eseguendo realmente l'esperimento dobbiamo invece constatare che le cose non stanno così! Conducendo realmente l'esperimento otteniamo un motivo a strisce, a prima vista inspiegabile, nel quale si può riconoscere una successione regolare di striature chiare e scure. Dunque, nell'esperimento con la luce, è ovvio che:


I fotoni che attraversano la fenditura 1 e quelli che arrivano dalla fenditura 2 non possono essere semplicemente sommati tra loro."

Quello che Silvia Arrojo ci vuol far comprendere è che aprendo 2 fenditure (e qui sta il bello), si forma una figura, il pattern di interferenza, tipico delle onde.
La conclusione che si può dare a proposito di questo esperimento è pertanto che la luce risulta formata da particelle, i fotoni, ma allo stesso tempo, in alcune circostanze, si comporta alla stregua di un'onda.
In termini più rigorosi si dice che sussiste un dualismo onda-corpuscolo!

6) ESPERIMENTO DI DAVISSON-GERMER

Abbiamo osservato dunque come l'esperimento di Young della doppia fenditura, alla fine, ci conduce alla pazzesca conclusione che la luce, a seconda delle circostanze, si comporta come un'onda o come una particella, ossia sussiste il dualismo onda-corpuscolo.
Ma ciò è vero solo per quanto riguarda la luce?
No: Louis de Broglie aveva ipotizzato che il dualismo onda-corpuscolo interessasse non solo la luce, ma anche le varie particelle, come l'elettrone.
L'esperimento volto a dimostrare questo assunto è appunto l'esperimento di Davisson-Germer del 1927.
Nel suddetto anno, ai Bell Labs, Clinton Davisson e Lester Germer spararono elettroni a velocità ridotta contro un bersaglio di nichel cristallino.
Essi misurarono la dipendenza dall'angolo di incidenza dell'elettrone riflesso, osservando che aveva lo stesso pattern di diffrazione dei raggi X, come previsto da Bragg.
Pertanto, l'ipotesi di de Broglie era stata effettivamente verificata!

CONCLUSIONE

Abbiamo analizzato alcuni importanti e interessanti esperimenti della storia della Fisica.
Ovviamente essi rappresentano una ristretta porzione della totalità di esperimenti compiuti da esimi scienziati all'interno della storia della Fisica.
Anche con una modesta quantità di esperimenti analizzati, però, possiamo constatare come essi siano assolutamente fondamentali allo sviluppo della disciplina.
Come abbiamo visto, Einstein deve in parte all'esperimento di Michelson-Morley l'implementazione della Relatività, Maxwell ha potuto elaborare le sue famose equazioni basandosi sugli esperimenti condotti da Ørsted, Faraday e Ampère, la veridicità dell'ipotesi di De Broglie sul dualismo onda-corpuscolo si deve all'esperimento di Davisson-Germer e così via.
Sintetizzando: per lo sviluppo della Fisica Teorica è necessaria la Fisica Sperimentale e viceversa!

P.S: ecco alcuni video di una pianista, Valentina Lisitsa, la cui velocità di esecuzione tende alla velocità della luce!!! ;)


giovedì 20 ottobre 2011

L'INDACO E I BLUE JEANS

La sostanza chimica di cui parleremo in questa trattazione è l'indaco.
Ma cosa c'entra con i comunissimi blue jeans che ci mettiamo indosso?
Lo scopriremo fra poco!
Intanto andiamo a capire che cos'è l'indaco.
A primo acchito il nome può richiamare in mente il colore dalla denominazione omonima, uno dei colori dell'arcobaleno, quella sfumatura particolare di blu, che tra l'altro, ricollegandoci alla Fisica, rappresenta il colore associato alla frequenza più alta (e conseguentemente alla lunghezza d'onda più piccola) compresa nell'intervallo dello spettro elettromagnetico tra i 420 e i 450 nanometri.
In effetti, per quanto concerne la Chimica, l'indaco è un colorante ed è blu.


Ergo, il termine è proprio azzeccato per designare tale composto chimico.
L'indaco, in natura, è prodotto da una pianta, appartenente alla famiglia delle papilionacee (come i piselli e i fagioli), denominata dal famoso botanico svedese Linneo Indigofera tinctoria.
La suddetta pianta, tra l'altro, può superare un metro e mezzo di altezza in climi sia tropicali che subtropicali.
L'indaco, però, può essere generato anche in regioni maggiormente temperate da un'altra pianta, il guado (Isatis tinctoria), rappresentante una delle piante coloranti più antiche dell'Europa e dell'Asia.
Si narra che Marco Polo, durante i suoi viaggi risalenti a 700 anni fa, avesse visto utilizzare l'indaco nella valle dell'Indo e dunque, da ciò sarebbe derivato il termine con cui è nota questa pianta.
Tuttavia, l'indaco (la pianta) si poteva riscontrare in numerose altre parti del globo, fra cui l'Asia sudorientale e l'Africa, molto tempo prima dei leggendari viaggi di Marco Polo.
Una precisazione: le foglie fresche delle piante produttrici di indaco non sono blu.
Infatti, tale colore compare a seguito della loro fermentazione in condizioni alcaline e dopo l'ossidazione.
Il processo appena descritto fu scoperto da diverse culture in tutto il mondo, probabilmente quando le foglie della pianta venivano accidentalmente irrorate da urina o ricoperte di ceneri, e poi lasciate a fermentare.
In cotali circostanze si sarebbero generate casualmente le condizione favorevoli affinché si producesse l'intenso colore blu dell'indaco.
Il composto precursore dell'indaco, che si può riscontrare in tutte le piante produttrici dell'indaco stesso, è l'indicano, il quale è un glucoside, ovvero una molecola contenente un'unità di glucosio.
L'indicano è incolore, ma la sua fermentazione in condizioni alcaline fa sì che si stacchi l'unità di glucosio, andando in tal modo a produrre un'ulteriore molecola: l'indossile.
Quest'ultima, a sua volta, reagendo con l'ossigeno dell'aria, va a dar vita appunto all'indaco (o indigotina), che possiede il suo caratteristico colore blu.
Pertanto, per secoli e secoli, l'indaco fu prodotto attraverso tali metodi "naturali".
Sorge una domanda: tale importante sostanza è stata successivamente sintetizzata in laboratorio?
La risposta è sì: la sintesi dell'indaco si deve al chimico tedesco Johann Friedrich Wilhelm Adolf von Bayer, il quale, dapprima, nel 1865, iniziò a studiare approfonditamente la struttura dell'indaco, e poi, nel 1880, lo produsse appunto sinteticamente, mediante 7 distinte reazioni chimiche.
Egli vinse il premio Nobel per la Chimica nel 1905 con la seguente motivazione: per"i suoi servizi nel progresso della chimica organica e dell'industria chimica, grazie al suo lavoro sui coloranti organici e i composti idroaromatici".
Tuttavia, dopo l'importante risultato scientifico di Bayer, furono necessari altri 17 anni prima che l'indaco sintetico, preparato con modalità differenti e messo sul mercato dalla società chimica tedesca Badische Anilin und Soda Fabrik (BASF), diventasse un prodotto commercialmente disponibile.
Ciò comportò l'immediato declino della grande industria dell'indaco naturale, un mutamento che andò a cambiare il modo di vita delle migliaia di persone che derivavano i loro mezzi di sussistenza proprio dalla coltivazione e dall'estrazione dell'indaco naturale.
Come però ci fa notare Joe Schwarcz nel suo libro Benzina per la mente:

"La cosa più importante fu che la scoperta del procedimento per la sintesi dell'indaco si tradusse nella disponibilità di migliaia e migliaia di acri di terreno in India per la coltivazione di cereali.  Grazie a ciò, si poterono sfamare molte più persone di quante l'esportazione dell'indaco sarebbe mai riuscita a fare."

Oggi una produzione annuale di più di 14000 tonnellate fa dell'indaco sintetico uno dei più importanti coloranti industriali.
Riporto qui sotto la formula di struttura dell'indaco:


La sua formula bruta è invece: C16H10N2O2.
Dopo queste disquisizioni, torniamo alla domanda iniziale: cosa ha a che fare l'indaco con i blue jeans?
Dovreste averlo capito ormai: esso, nonostante non sia un colore ad elevata solidità, viene utilizzato proprio per tingere i blue jeans.


Colui che per primo fece uso dell'indaco per tingere i jeans è stato Levi Strauss, il quale approfittò, nel 1853, della scoperta di oro in California per recarsi lì, al fine di aprire un negozio pieno di oggetti utili ai lavoratori.
Un giorno, egli scoprì che i lavoratori desideravano dei vestiti e quindi, cercò di produrne alcuni che dovevano essere resistenti e comodi: i blue jeans.
Oggi l'innovativa idea di Levi Strauss riscuote ancora un grandissimo successo: infatti milioni e milioni di paia di blue jeans sono confezionati con tessuto tinto con indaco deliberatamente sbiadito.
Possiamo concludere che prendendo come riferimento un oggetto d'uso quotidiano, in questo caso i blue jeans, ci si accorge come la chimica sia situata dappertutto, tutta attorno a noi.
La Chimica, come d'altronde le altre scienze, è un qualcosa di imprenscindibile dalla nostra quotidianità, anche se molto spesso non ce ne accorgiamo!


P.S: visto che abbiamo richiamato il colore blu più e più volte, riporto alcuni brani musicali inerenti appunto il colore blu:


mercoledì 12 ottobre 2011

UNA FAMIGLIA DI MATEMATICI: I BERNOULLI

Questa è la storia di una famiglia di matematici e fisici svizzeri che, a cavallo tra il XVII e XVIII secolo, ha fornito importantissimi contributi a tali discipline: trattasi della famiglia Bernoulli.
Come racconta Eric Bell nel suo noto saggio "I grandi matematici":

"[La] famiglia Bernoulli nel corso di 3 generazioni ha dato 8 matematici, di cui diversi eminenti, che a loro volta hanno avuto una discendenza d'intelletti superiori alla media, almeno per ciò che concerne la metà di essi, fino ai giorni nostri. È stato studiato un albero genealogico con non meno di 120 discendenti dei Bernoulli matematici, e fra loro si contano numerose personalità che si sono distinte, spesso in modo eccezionale, nel diritto, nell'erudizione, nella scienza, nella letteratura, nelle libere professioni, nell'amministrazione e nelle arti. Non ci furono fallimenti. La caratteristica della maggior parte dei matematici della seconda e terza generazione, è che essi non hanno scelto direttamente la matematica come professione, ma sono stati attratti verso di essa come un ubriacone inveterato verso l'alcol. La famiglia Bernoulli ha avuto una parte di primo piano nel progresso del calcolo infinitesimale e delle sue applicazioni nel corso del XVII e XVIII secolo...Infatti, i Bernoulli ed Eulero sono stati veramente coloro che, dominando gli altri, hanno condotto il calcolo infinitesimale a un punto tale che anche le intelligenze comuni possono utilizzarlo per arrivare a certi risultati ai quali i sommi Greci non avrebbero mai potuto attingere...I Bernoulli discendono da una famiglia protestante che fuggì da Anversa nel 1583 per sottrarsi ai massacri degli ugonotti da parte dei cattolici (come quello della notte di San Bartolomeo); questa famiglia si rifugiò a Francoforte e si trasferì in seguito in Svizzera, dove si stabilì a Basilea. Il fondatore della dinastia dei Bernoulli si unì, attraverso il matrimonio, a una delle più vecchie famiglie di Basilea e diventò un gran commerciante. Nicolaus il Vecchio, capostipite della tavola genealogica, fu pure un gran commerciante, come erano stati suo nonno e il suo bisnonno; tutti questi uomini avevano sposato delle figlie di commercianti e, tranne il bisnonno, avevano accumulato delle grosse fortune. Il primo che si allontanò dalla tradizione si fece medico; il genio matematico era probabilmente latente da qualche generazione e si manifestò improvvisamente a un dato momento."


A seguito di questo excursus storico sulla famiglia Bernoulli, andiamo ad analizzare alcuni dei più importanti risultati ottenuti da esponenti della suddetta famiglia nei campi della matematica, della fisica e della statistica.
Partiamo dal Teorema (o Equazione) di Bernoulli inerente la fluidodinamica.
Per la trattazione specifica di questo teorema vi rimando all'articolo "Il teorema di Bernoulli e il gioco del calcio".
Tuttavia, in questa sede, andiamo a capire chi ha elaborato il suddetto teorema: il suo nome è Daniel (I) Bernoulli (1700-1782).
Figlio di Johann I, cominciò all'età di 11 anni a prendere lezioni di matematica dal fratello maggiore Nicolaus, che era 5 anni più grande.
Daniel ebbe una relazione di amicizia/rivalità con il grande Eulero e come quest'ultimo, Daniel ottenne per la bellezza di 10 volte il premio dell'Accademia delle scienze di Parigi.
Nel 1725, all'età di 25 anni, Daniel fu nominato professore di matematica a San Pietroburgo, ma l'atmosfera per niente accogliente di quella città lo spinse 8 anni più tardi a ritornare a Basilea, nella quale insegnò anatomia, botanica e fisica. 
I suoi contributi in matematica riguardano il calcolo infinitesimale, le equazioni differenziali, il calcolo delle probabilità, la teoria delle corde vibranti, la teoria cinetica dei gas e numerosi altri problemi di matematica applicata (oltre al celebre teorema sulla fluidodinamica).
Per tali indubbie ragioni è stato chiamato il fondatore della fisica matematica.
Dopo la trattazione sulla biografia di Daniel Bernoulli, andiamo ad analizzare le seguenti importanti scoperte dovute ad un Bernoulli:
  • Disuguaglianza di Bernoulli;
  • Legge dei grandi numeri;
  • Distribuzione di Bernoulli.
La scoperta di queste importanti nozioni e leggi matematiche si deve a Jacob (I) Bernoulli (1654-1705).
Fu proprio egli il primo della famiglia Bernoulli a raggiungere un ruolo molto significativo nel campo della matematica.
Era nato a Basilea, nella quale morì, ma nel corso della sua vita intraprese numerosi viaggi per incontrare colleghi scienziati di altri paesi.
I suoi interessi erano stati orientati verso le ricerche sugli infinitesimi dalla lettura delle opere di Wallis e Barrow.
Inoltre, la lettura degli scritti di Leibniz risalenti agli anni 1684-1686 gli consentì di far propri alcuni nuovi metodi, al punto che, nel 1690, suggerì a Leibniz il termine di "integrale" e pubblicò degli scritti propri sull'argomento nell'opera Acta Eruditorum.
Si interessò fin da subito anche alle serie infinite e nel suo primo scritto sull'argomento, risalente al 1689, presentò la celebre "disuguaglianza di Bernoulli":


Bisogna specificare che essa vale per ogni numero reale x maggiore o uguale a -1 e per ogni numero intero n maggiore o uguale a 0.
In simboli, tali condizioni si traducono in questa maniera:

∀x ∈ R : x ≥ -1  e  ∀n ∈ Z : n ≥ 0

Tale importante disuguaglianza si dimostra per induzione.
Ma come funziona la dimostrazione per induzione?
Essa segue 2 passi:

1) dobbiamo dimostrare che una proposizione dipendente da un indice n appartenente (∈) all'insieme dei numeri naturali (N) sia vera per n=1;
2) dobbiamo dimostrare che la medesima proposizione ipotizzata vera per n, rimanga vera anche per il successivo n+1.

Se vengono dimostrate entrambe le condizioni, allora la proposizione di partenza è vera ∀n ∈ N.
A proposito di principio di induzione, andiamo a capire da dove deriva, attraverso la splendida narrazione di Carl Boyer in Storia della Matematica:

"Negli ultimi anni del XIX secolo vi furono alcuni matematici italiani che si interessarono profondamente alla logica matematica. Il più noto era Giuseppe Peano (1858-1932), il cui nome viene ancor oggi ricordato in relazione ai cosiddetti assiomi di Peano, dai quali dipendono molte costruzioni rigorose dell'algebra e dell'analisi...Nel suo Formulario di matematica (1894 e ss.) egli si proponeva di sviluppare un linguaggio formalizzato che potesse contenere non solo la logica matematica, ma tutti i risultati dei più importanti settori  della matematica...Per i suoi fondamenti dell'aritmetica Peano scelse 3 concetti primitivi (zero, numero, ossia numero intero non negativo, e la relazione di "essere il successivo di"), i quali soddisfano 5 postulati:

1) Zero è un numero;
2) Se a è un numero, il successivo di a è un numero;
3) Zero non è il successivo di nessun numero;
4) Due numeri, i cui successivi sono uguali, sono essi stessi uguali;
5) Se un insieme S di numeri contiene zero e contiene anche il successivo di ogni numero contenuto in S, allora ogni numero è contenuto in S.

L'ultimo postulato è, naturalmente, l'assioma di induzione. Gli assiomi di Peano, formulati per la prima volta nel 1889 negli Arithmetices principia nova methodo exposita, rappresentano il tentativo più singolare fatto nel XIX secolo di ridurre l'aritmetica comune, e di conseguenza in ultima istanza la maggior parte della matematica, alla pura essenzialità di un simbolismo formale. (Va ricordato che egli presentò i suoi postulati esprimendoli in simboli, e non con le parole che abbiamo qui usato)."     

Ergo, dopo l'excursus sul principio di induzione e su Giuseppe Peano, ora possiamo passare alla dimostrazione della disuguaglianza di Bernoulli.

DIMOSTRAZIONE

Verifichiamo la condizione n.1 (base dell'induzione): per n = 1 la proposizione è vera (si ottiene infatti un'uguaglianza):

1+ x = 1 + x

Verifichiamo la condizione n.2 (passo induttivo): supponiamo vera la disuguaglianza di Bernoulli originaria; dobbiamo provare che risulti ancora vera se al posto di n ci sta (n + 1).
A tal proposito moltiplichiamo entrambi i membri per (1 + x), che rappresenta una quantità ≥ 0:


Adesso, poiché nx² ≥ 0, possiamo ometterlo dalla nostra espressione, perchè tale azione renderebbe solo più forte la relazione di disuguaglianza.
Ergo, alla fine otteniamo:


In questa maniera siamo riusciti ad ottenere la proposizione con (n+1) al posto di n.
Pertanto, in accordo con il principio di induzione, abbiamo dimostrato la disuguaglianza di Bernoulli!
Essa è fondamentale per la dimostrazione di altre disuguaglianze in analisi matematica.
Un altro importante contributo di Jacob Bernoulli è la famosa "Legge dei grandi numeri".
A cosa si riferisce e soprattutto, che cos'è?
Innanzitutto, essa riguarda il calcolo delle probabilità.
Ricordiamo intanto che la definizione "classica" di probabilità ci dice che essa equivale al rapporto fra i casi favorevoli e quelli possibili di un evento casuale.
Per fare un semplice esempio, quante sono le probabilità che esca un numero pari lanciando un dado?
Il dado ha 6 facce, 3 rappresentano numeri pari, le restanti 3 numeri dispari.
Essendo la probabilità il numero dei casi favorevoli diviso il numero dei casi possibili, otteniamo che:

Ppari = 3/6 = 1/2 = 50%

Dalla definizione di probabilità classica ci accorgiamo che essa è valutata a priori, cioè prima che l'evento (nell'esempio il lancio del dado) accada.
La definizione classica di probabilità non è quindi applicabile a tutte le situazioni.
Inoltre, la stessa definizione è oggetto di critiche, le quali partono dalla considerazione che affermare che tutti i casi sono ugualmente probabili significa fare appunto a priori una supposizione sulla loro probabilità di verificarsi, utilizzando così nella definizione lo stesso concetto che si vuole definire: una sorta di paradosso!
A partire da queste considerazioni si è sviluppato un nuovo concetto di probabilità, la concezione statistica o frequentistica, la quale può essere chiamata in causa nel momento in cui sono disponibili rilevazioni statistiche relative a un certo fenomeno oppure quando, riguardo a un determinato evento, si possono eseguire numerose prove.
La concezione statistica della probabilità si regge sulla definizione di frequenza relativa di un evento.
La frequenza relativa f(E) di un evento sottoposto a n prove (o esperimenti), effettuati tutti nelle medesime condizioni, è il rapporto tra il numero v delle volte in cui si è verificato l'evento e il numero n delle prove effettuate:

f(E) = v/n

Facciamo un esempio: consideriamo il lancio di una moneta: la probabilità classica teorica che si verifichi l'evento E = esce testa, è pari a p(E) = 1/2 = 50%.
Se operativamente si lancia la moneta un numero molto elevato di volte, si può constatare che il numero di volte in cui si presenta testa è quasi uguale al numero di volte in cui si manifesta croce.
In altri termini, la frequenza relativa dell'evento E si avvicina al valore teorico p(E) = 1/2.
In generale, la frequenza relativa varia tra 0 e 1.
Essa vale:
  • 0: nel caso in cui, negli esperimenti eseguiti, l'evento non si sia mai verificato;
  • 1: se l'evento si è sempre verificato.
Le considerazioni precedenti si possono generalizzare proprio attraverso la Legge dei grandi numeri (o Legge empirica del caso o Teorema di Bernoulli):

⎛Dato un evento casuale E, sottoposto a n prove eseguite tutte nelle stesse condizioni, il valore della frequenza relativa f(E) = v/n tende al valore della probabilità (classica) p(E) all'aumentare del numero di prove effettuate⎞.

La probabilità statistica è proprio diretta conseguenza di tale legge.
Essa, a differenza di quella classica, è valutata a posteriori.
La definizione rigorosa di probabilità frequentistica di un evento proviene da Richard von Mises, che la definì come "il limite cui tende la frequenza relativa dell'evento al crescere del numero degli esperimenti".
In simboli:


dove nA/n è la frequenza relativa.
Un'ulteriore scoperta di Jacob Bernoulli è la "Distribuzione di Bernoulli".
Essa vale per le variabili casuali (o aleatorie o stocastiche) discrete.
Ma cosa sono le variabili casuali?
Una variabile casuale X è una funzione definita sullo spazio campionario Ω che associa ad ogni evento E appartenente (∈) a Ω un unico numero reale.
Le variabili aleatorie si suddividono in 2 classi:

1) discrete: possono assumere un insieme discreto (ossia finito, limitato, numerabile) di numeri reali;
2) continue: possono assumere tutti i valori compresi in un intervallo reale.

Siccome si può associare una misura di probabilità a tutti gli eventi E inclusi (⊂) in Ω, allora si può associare una probabilità anche ai valori che può assumere la variabile casuale X.
Nel caso della variabili casuali discrete (quelle che ci interessano in tale contesto) si può definire la funzione di probabilità: essa associa ad ognuno dei possibili valori xi della variabile, la corrispondente probabilità P(X = xi).
Prima di andare a vedere cos'è la distribuzione di Bernoulli, dobbiamo definire 2 importanti concetti per le variabili discrete:

1) valore medio;
2) varianza.

Il valore medio, chiamato anche valore atteso o speranza matematica, è la somma di tutti i valori assunti dalla variabile, ciascuno moltiplicato per la propria probabilità.
In simboli:


La varianza, che ci fornisce una misura di come varia la variabile casuale, è definita come la somma degli scarti al quadrato del valore atteso, con ognuno dei valori moltiplicato per la propria probabilità.
In simboli è decisamente più facile da comprendere:


Ricordiamo che il simbolo Σ, che rappresenta la lettera greca "sigma maiuscola", significa "sommatoria" e che gli scarti del valore atteso si possono identificare come la differenza tra i singoli valori che assume la variabile e il valore medio.
Detto ciò, passiamo al nocciolo della questione: la Distribuzione di probabilità di Bernoulli (o bernoulliana).
Una distribuzione, in parole semplici, ci dice (anche mediante un grafico specifico) come sono appunto distribuite le misure della variabile tra i diversi valori possibili.
La distribuzione di Bernoulli è interessante nel caso si possa verificare solo se un certo evento si è o non si è verificato.
La variabile casuale generata da tale prova assumerà, per convenzione, il valore: 

  • 1: se l'evento si è verificato; 
  • 0: nel caso in cui non si sia verificato. 
Tale variabile è detta variabile casuale di Bernoulli.
Essa può assumere il valore 1 con probabilità π e il valore 0 con probabilità 1-π.
La sua funzione di probabilità può essere espressa come:


La media di questa distribuzione è:

E(X) = π

La varianza è invece:

V(X) = π(1-π)

Pertanto, tutte le prove/esperimenti che producono solo 2 possibili risultati danno vita a una variabile casuale di Bernoulli come, ad esempio:

- il lancio di una moneta;
- il sesso del nascituro;
- il verificarsi di un "doppio 6" nel lancio di 2 dadi;
- la presenza/assenza di una certa caratteristica, ecc.


Un'ultima curiosità matematica legata a Jacob Bernoulli: egli, nel 1694, ha descritto una curva estremamente singolare, denominata "lemniscata di Bernoulli".
Si tratta di una curva algebrica a forma di 8 coricato, che risponde, in coordinate cartesiane, all'equazione:


Dunque, il grafico della suddetta funzione produce una forma simile a quella del simbolo dell'infinito:


La lemniscata fu descritta da Bernoulli come una modificazione dell'ellisse.
Infatti, se quest'ultimo è il luogo dei punti per i quali la somma delle distanze da dei punti fissi chiamati fuochi è costante, nel caso della lemniscata si ha la medesima definizione, ma ci si riferisce al prodotto delle distanze che risulta costante.
Il nome originario latino che Bernoulli assegnò a tale figura è lemniscus, che sta a significare "fiocco pendente".
In conclusione, riporto una frase di J. Bernoulli a proposito della famiglia Bernoulli:

"Questi uomini hanno certamente compiuto molte opere e hanno meravigliosamente raggiunto lo scopo che si erano prefissi".